第 2 章 意图路由、工具选择与失败降级
2.1 意图 Router
Router 只负责分类与分发,具体 Agent 负责执行,最后可由
finalize统一输出结构、模型信息和用量。
图解:先分清任务,再交给对应处理者
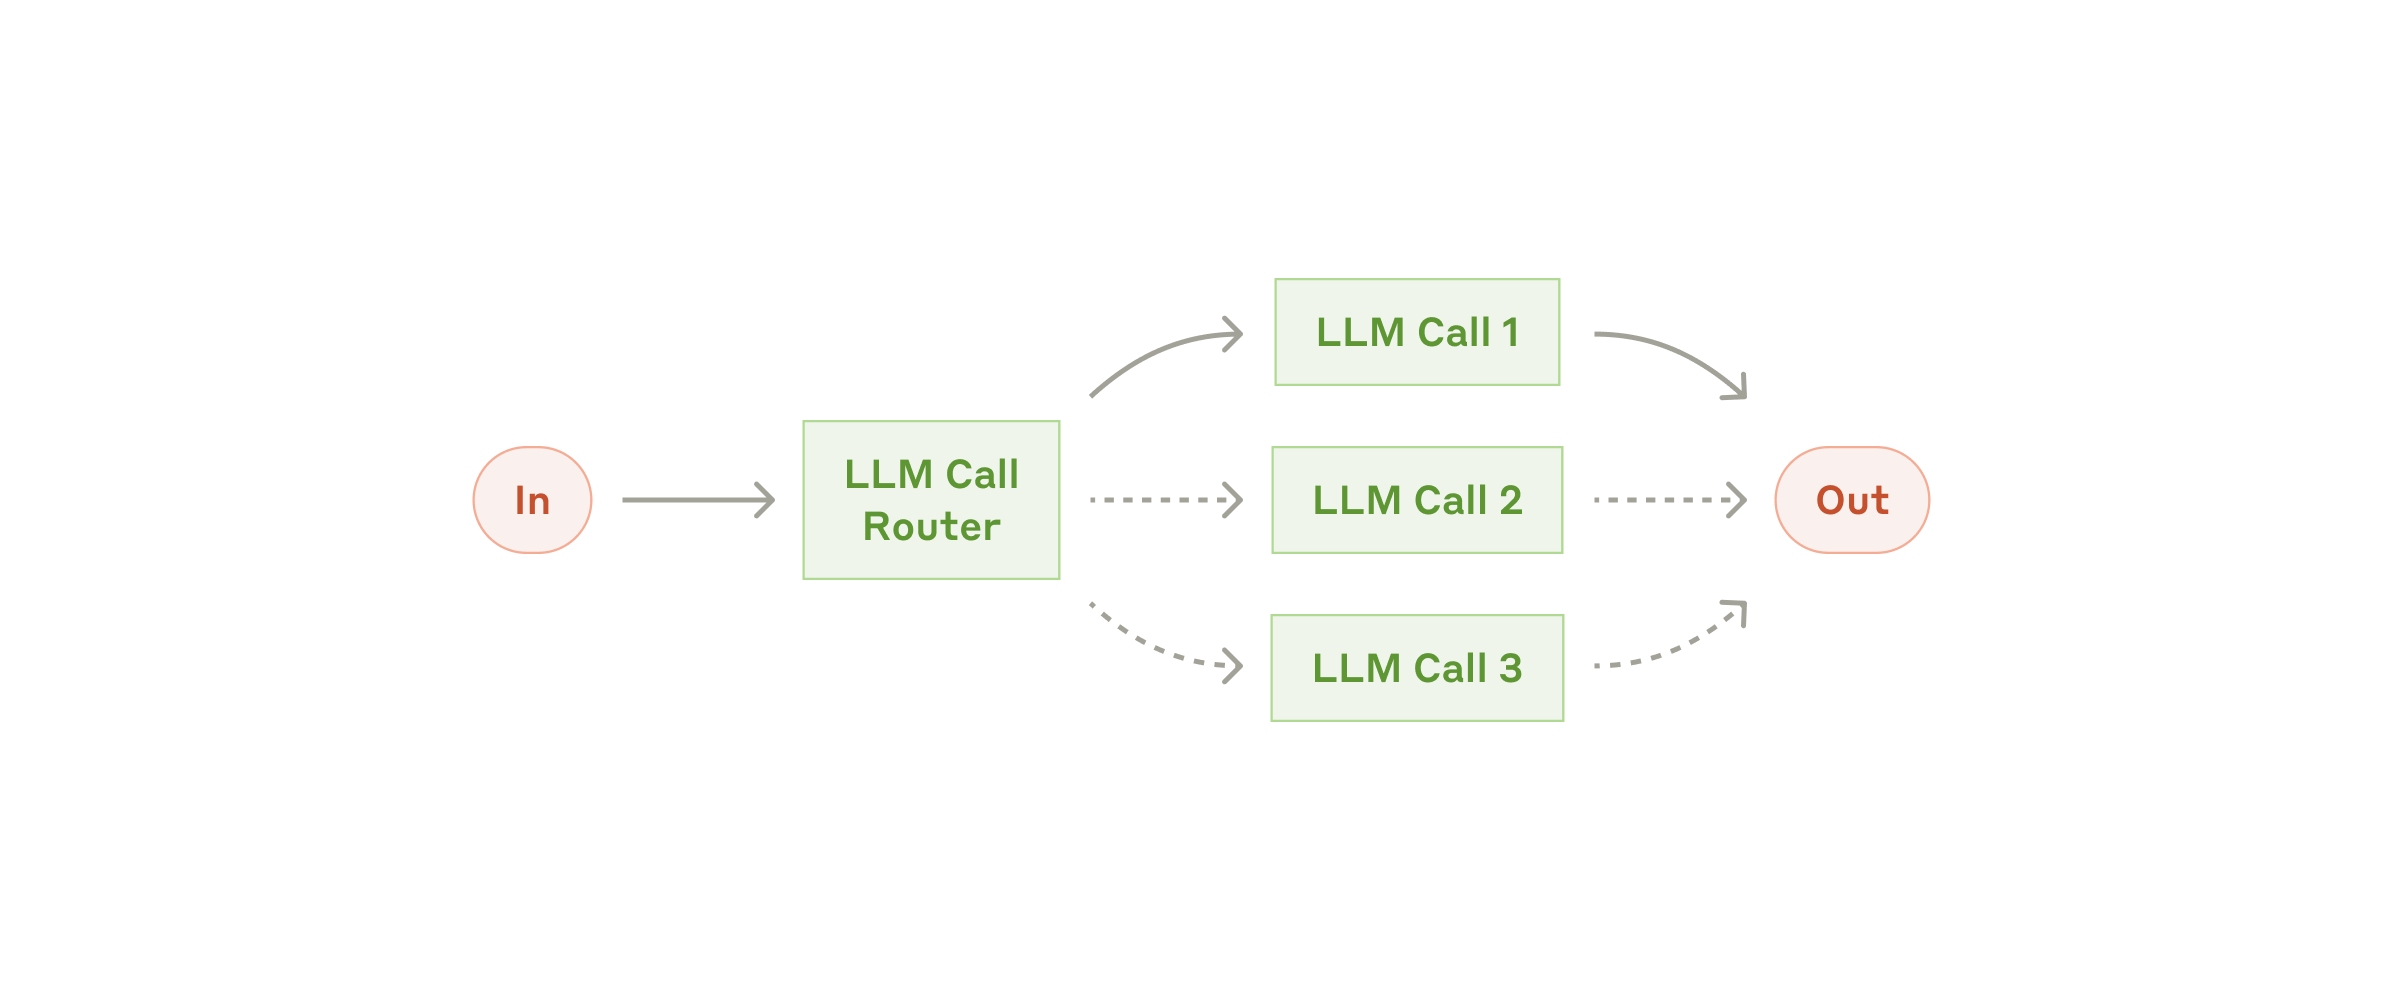
读图: 从左往右看:输入先经过 Router,再进入其中一条处理路径。图中的三条分支不表示每次都要执行;不确定时的澄清与权限检查仍按本节处理。
来源:Anthropic《Building effective agents》Routing 原图(2024)。2026-10-28 核对。
用户消息 → classify 分类 → 对应 Agent 执行 → finalize 收尾我踩过的坑
- 2026-06-20 我问过:“问天气时 Agent 调工具,工具算路由吗?”“Agent 只有一个路由吗?”
正确理解
- 用户输入可能是闲聊、查数据、生图或执行任务。上面是使用 Router 与 finalize 的一种实现,不是所有 Agent 的固定流程。
- 三种东西要分开:HTTP 路由按 URL 找处理函数;意图 Router 按消息内容分派任务;Tool Call 是执行过程中的一次动作。
- 闲聊和查天气可以共用
/chat,/health、/history、/upload等 HTTP 接口可以独立设置。工具数量不等于路由数量。
2.2 规则路由与 LLM Router
能用规则路由,就不强行加模型。
正确理解
- /help、明确的按钮命令可以直接映射到 Handler;自然语言含糊时,再考虑 LLM Router。
- 路由结果尽量是小而稳定的枚举,例如 intent = search / chat / unknown,不要让模型自由写一大段让下游再猜。
2.3 Unknown、Fallback 与错误路由
分类不确定时返回 unknown、请求澄清或进入安全的低风险兜底,不能硬选一个可能执行危险动作的分类。
我踩过的坑
- 以为评估 Router 主要看总体分类准确率。
正确理解
- 分类不确定、输入不完整或 Router 超时,都属于这种情况。
- 要看错到哪里、造成什么后果。把普通问题误送到高风险工具,比转给普通聊天更危险。
- 兜底通道也需要安全边界。
finalize只统一输出格式,不能撤销错误操作;身份、授权和危险操作检查要在执行前完成。 - 替换 Router 小模型时,保留程序契约并重新校准评测。 先固定分类集合、输出结构、多轮上下文和路由行为,只换决策模型;用相同样本测各类准确率、拒判和资源占用,再重新校准各类阈值。旧模型的置信度不能直接套给新模型。
2.4 多轮对话的上下文
Router 要有适量的上文和任务状态,但不必把所有历史全塞进去。
我踩过的坑
- 我问过:“最近 3 条上下文,算几轮对话?”
正确理解
- 用户先说“帮我查昨天的记录”,接着问“那前天呢”,第二句单独看无法判断意图。
- 通常 1 条 user 或 assistant 消息算 1 条。“上一轮用户 + 上一轮助手 + 当前用户”只包含一轮完整历史,3 条不等于 3 轮。
- 旧稿记录的一个具体实现:先从当前 conversation/session/channel 取最多 30 条候选,筛出允许进上下文、通过脱敏与状态筛选的消息,取最近 3 条;Router 判断有依赖后,才决定回答 Agent 是否收到历史。
- 原笔记把其中一个筛选条件写成“未脱敏”,字段含义还没核实,不能理解为可以省略敏感信息检查。筛选规则、Router 失败后的恢复和人工复核仍待验证。固定条数和依赖分类都要真实验证,不能把所有旧消息往 Context 里塞。
动手前检查
- 排查路由要保存输入摘要、所用策略或模型版本、路由类别、实际接手的 Handler,否则分不清是 Router 错还是 Handler 错。
来源
原始深入笔记:Agent 意图路由。
历史窗口要分别数,筛选规则要按版本核对
2026-11-05 的架构笔记把数据库候选、模型聊天窗口、长期记忆条目与画像抽取输入分开:历史中的30、3、5、4分别属于不同窗口,不可互换。分类器先看到构建后的历史;回答器只在判为依赖时使用普通历史,画像还可单独注入。候选很多不代表回答器实际看到了它们。
较早笔记笼统写“失败回复排除”,后续快照记载允许失败或部分回复并附原因;命令也有允许和不允许进上下文的区别。两者是历史证据差异,本轮不推定生产当前值。配置名、默认值和“曾上线5条”的口述也不能互证;旧文只找到20改3的代码历史。
2.5 Router、FSM 与 RAG
Router 决定任务交给谁,FSM(有限状态机)约束业务步骤,RAG 检索所需资料。三者可以协作,不能相互替代。
正确理解
- 退货示例:用户说“衣服太小了,我想退货”。Router 找到售后流程;模型可以提取退货原因;订单号没给时,FSM 停在“收集信息”状态并追问。资料齐全后,程序再做身份、风控和退款检查。
- RAG 可以查退货政策,但检索结果不能代替交易校验。
- 待复习:分类错了,为什么最终统一回复格式也不能补救业务判断?原练习没有记录我的作答。
2.6 LangGraph 的节点、边和状态
LangGraph 把流程拆成节点(每一步做什么)、边(下一步去哪)、状态(步骤间传什么数据)。它是编排工具,不是意图分类模型。
正确理解
- 固定流转可以声明边;按意图选下一步,由当前节点返回路由结果。
StateGraph、add_node、add_edge、compile是一种具体实现方式。 - 不是所有 Agent 都必须画图。原来的 Router 可以按“分类 → 执行 → 收尾”实现,这只是其中一种图结构;用不用它,看流程复杂度和状态管理需求。
- 线性链与有状态图:步骤固定、基本单向的“检索→生成→输出”,用简单的 Chain 或函数组合即可;需要条件分支、循环调用工具、人工审核或跨轮状态恢复时,再考虑图编排。两者不是“旧版/新版”的替代关系,选择依据是实际控制流,不是框架热度。
2.7 Router 分类失败的兜底
分类失败时一律丢掉上文,能防止误传历史,也会制造错误指代。
我踩过的坑
- 旧草稿把“上下文依赖分类失败”一律兜底成
is_dependent=false,想减少上下文污染和 Token。可用户说“那前天呢”“它安全吗”“和刚才的比”时,模型只看到这一句,根本不知道“它”指什么。
正确理解
- 评测 Router 要分别看两种失败:假依赖(不需要历史却送入历史,可能引入污染和隐私风险)和假独立(确实需要上文却被截断,导致错误指代)。不能只看总准确率。
- Router 超时或分不清时,候选兜底有:让用户补全指代、只放与这轮有关的短摘要、再做一次低成本分类、对高风险请求直接停止。
- 是否默认只传当前消息,要用带“依赖/不依赖”标注的评测集比较成本和风险。选择了安全兜底不等于任务已完成。
来源
10-wiki/personal/wiki/queries/router分类失败时是否应默认不依赖上下文.md。这是历史方案讨论,不代表线上 Router 当前配置。