第 7 章 日志、指标、Trace 与故障排查
7.1 日志关联与 Trace
Log 记录事件,Metric 反映整体,Trace 串起一次请求。排障先用标识符关联它们。
| 类型 | 回答的问题 |
|---|---|
| Log(日志) | 某一步发生了什么 |
| Metric(指标) | 一段时间的服务是否健康 |
| Trace(链路追踪) | 一次请求经过什么节点、哪里慢 |
看一张真实界面:整条链路与单个步骤要分开读。
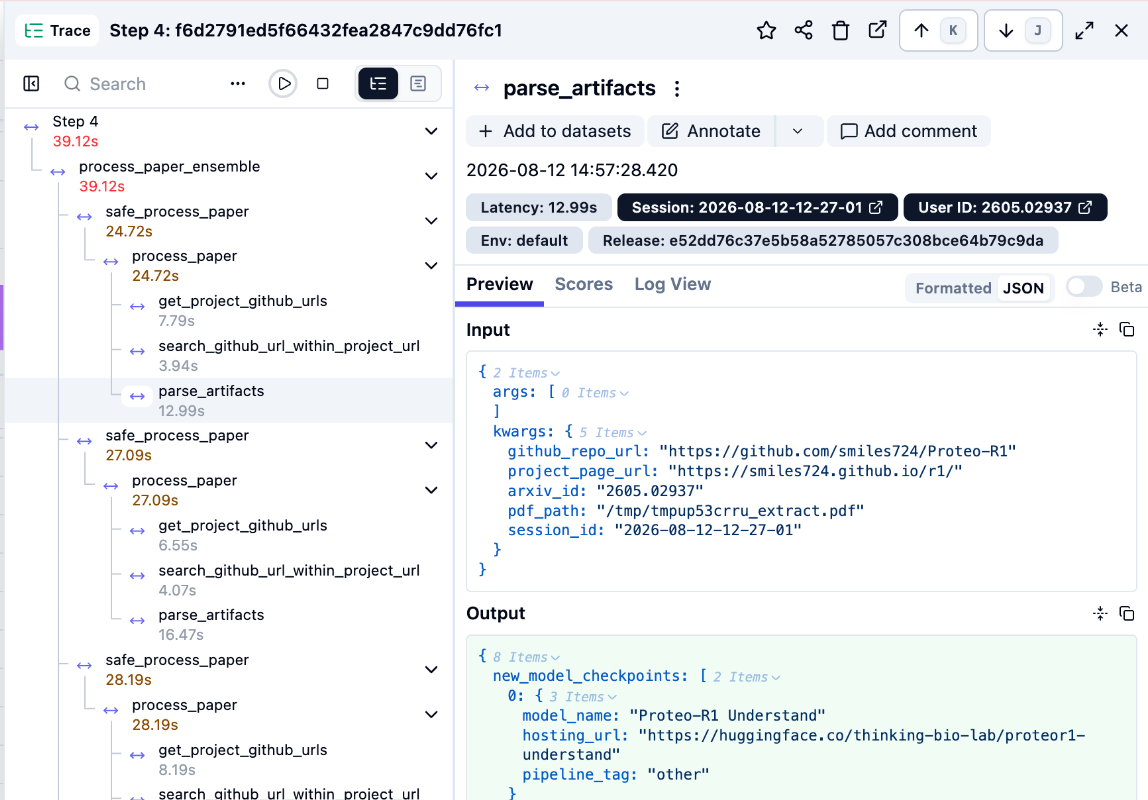
先看左侧的调用树找父子关系,再看右侧选中的步骤。图中根 Trace 的耗时是 39.12 秒,所选 parse_artifacts 是 12.99 秒;后者不是整次请求的总耗时。最后核对该步骤的 Input / Output,判断慢在什么操作,不能只看到一个耗时数字就下结论。
来源:Langfuse 官方可观测性文档,2026-10-28 核对;截图裁剪到调用树与详情区域,未改动界面数据;这是公开示例,不是我的生产数据。
正确理解
- 用
request_id、trace_id关联入口、业务、Worker 与下游,再记录阶段、耗时和错误类别。Trace ID 追踪一次调用链;订单号、情报 ID 标识业务对象,同一业务的多次请求通常各有可区分的 Trace ID,不因业务 ID 相同就合成一条链。 - Langfuse 等 SDK 可由 seed 生成确定性 Trace ID,便于按 Request ID 回查。Seed 仍有可关联性,业务 ID 放受控脱敏字段,别混入缓存键、完整 Prompt 或异常日志。
- Uvicorn access 缺
trace_id时,先查实际 handler、propagate和 Filter 的挂载位置。子 logger 向祖先 handler 传播时不经过祖先 logger 的 Filter,所以只给 root logger 加 Filter,即使propagate=True也补不上字段;应在实际输出 Handler 或创建记录时注入,再测并发是否串号、重复打印。 - 异步链路可用
ContextVar(contextvars.ContextVar)保存 Trace 上下文:入口 set,Filter 读取,finally中 reset。它跟随当前异步上下文,不保证自动跨线程或进程;StarletteBaseHTTPMiddleware的逆向传播有限制,必要时用纯 ASGI Middleware 验证。
7.2 日志脱敏与留存
日志先控制可写内容和访问权限,再谈脱敏、采样与保存多久。
我踩过的坑
- 为排障想记录完整 Provider 异常、模型输入输出,后来意识到里面可能有用户资料、内部地址或密钥。
正确理解
- 原始 Prompt、令牌、认证头、手机号按敏感等级控制;优先结构化字段允许列表,自由文本再做正则、截断、采样。脱敏要在本地持久化和上传平台前完成,保留
request_id、trace_id等关联字段。 - 业务事件、系统故障与审计日志按 Logger、事件类型、命名空间和权限分流;未知第三方库日志也要找到去处。日志文案中的 emoji 和关键词不适合做分类依据。
- Python
loggingHandler 负责滚动文件和句柄,直接open()只要正确关闭也未必泄漏。Handler 缓存旧路径时需随配置和生命周期重建。
来源
Python logging 的传播规则 · Langfuse Trace ID 文档 · OpenTelemetry Trace 语义 · Starlette Middleware 的 ContextVar 限制
观测序列化也会失败(历史整改):仅包住 SDK 调用还不够,model_dump()、截断与成功记录也要在观测隔离范围内。接口异常尚未由统一处理器映射时,不应先在 Trace 硬写 HTTP 500。接口级 Trace 会漏掉进入端点前的 422,需和访问日志、校验错误记录互补;文本截短只是控量,脱敏仍在持久化前做。见三服务的观测整改。
7.3 四个黄金信号
流量、延迟、错误、饱和度,分别看量、等待、失败与剩余容量。
看真实看板时,先认单位与统计口径。
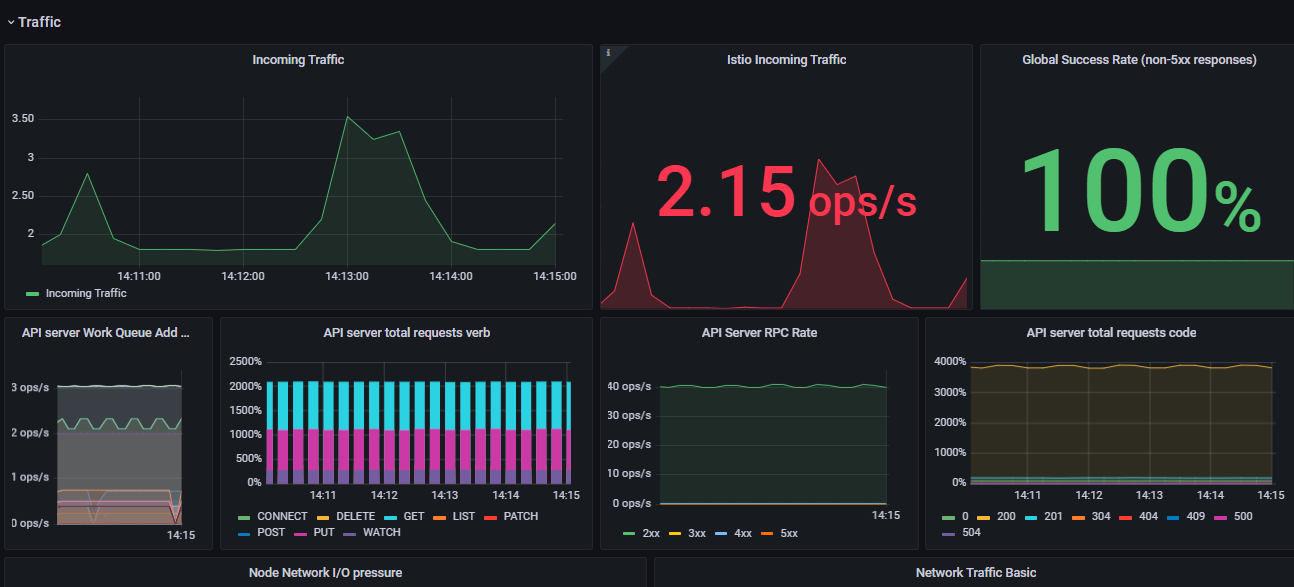
中间的 2.15 ops/s 是速率,不是累计次数。右侧虽然显示 100%,标题却限定为 non-5xx responses(非 5xx 响应):它不是“所有业务都正确”的证明,也没有回答延迟或资源是否接近上限。读一个大数字之前,先读标题、单位、时间范围,再关联其他黄金信号。
来源:Grafana 社区模板 Monitoring Golden Signals for Kubernetes 的原始截图,2026-10-28 核对;这是公开模板示例,不是本人的服务监控,也不代表模板里的所有单位配置都适用于当前项目。
我踩过的坑
- 看到
Active Tasks=0、Local Queue Usage=0%,就认定 Worker 没任务、闲着。
正确理解
- 流量看请求或任务数量,延迟看等待时间,错误看失败和重试,饱和度看 CPU、连接池、队列是否接近上限。
- Worker 指标要看它观察的是哪个位置:
| 指标 | 观察范围 |
|---|---|
Active Tasks |
Worker 当前正在执行的任务 |
Local Queue Usage |
Worker 进程内等待执行的任务 |
| 外部 MQ 积压 / Consumer Lag | 消费进度落后或外部消息积压,具体含义取决于消息系统和指标口径 |
- 以 Kafka 为例,消费位置和已提交位移不是一回事。按已提交位移算的 Lag,可能包含已经拉走、还没提交进度的记录,不能都当成没取走的消息,见 Kafka 消费位置说明。
- 两个零只说明那一刻 Worker 内部的状态,外部 MQ 可能还在积压,也可能任务刚好做完。先确认指标还在更新,再比较进入量、完成量和外部积压的变化。处理耗时 P95 的计时范围见第 7.4 节。
7.4 Gauge、Counter、Rate 与 P95
指标先看类型和口径,再谈数值高低。
| 概念 | 正确读法 |
|---|---|
| Gauge | 当前值,例如队列长度、活跃任务数 |
| Counter | 累计次数,通常关注一段时间内的增长量 |
| Rate | 一段时间内每秒或每分钟发生多少次 |
| P95 | 样本的第 95 百分位,要先确认样本和计时口径 |
分位数曲线,能看见“少数很慢”的请求。
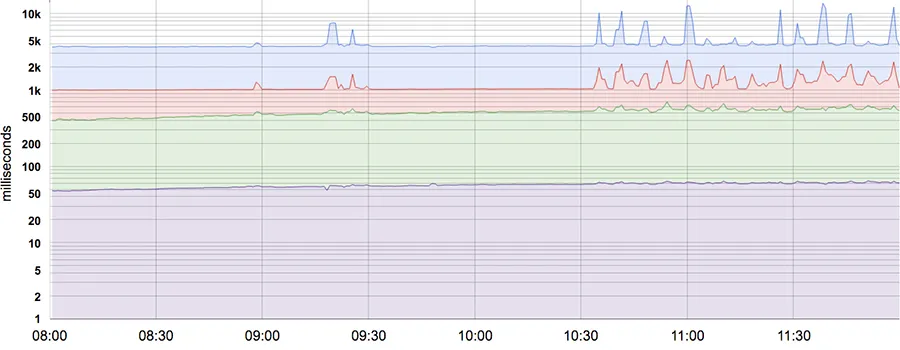
这张图从低到高展示 P50、P85、P95、P99。低处的 P50 比较平稳,上方的高分位仍会出现尖峰:典型请求不慢,不代表尾部请求也不慢。纵轴是对数刻度,不能把相同的竖直距离当作增加了相同毫秒数。它解释的是样本分布,仍不能替代下面对“从哪里开始计时”的检查。
来源:Google《Site Reliability Engineering》第 4 章 Service Level Objectives,Figure 4-1;© 2017 Google,O’Reilly 出版,CC BY-NC-ND 4.0。保留原图、未重绘或改动数据,用于本人非商业学习。
我踩过的坑
- 看到 Worker 处理耗时 P95≈4 秒,以为“消息至少排队 4 秒”或“用户一定等待 4 秒”。
正确理解
- 如果从 Worker 开始处理才计时,P95≈4 秒表示约 95% 的样本处理不超过 4 秒,不包含入队前和 MQ 排队,也不能代替用户的总等待时间。总等待要看端到端计时,先查清指标的实际定义。
- 错误率要用同一时间范围、同一口径的失败量和请求量来算。
- 读缓存命中率的分母,应该是符合统计口径的读取尝试。旧 Agent 的统计口径出过错,案例见附录 A.7.4。
7.5 告警与看板
看板帮助观察趋势,告警需要指向明确行动。
正确理解
- 设告警时要写清阈值、持续时间、聚合维度、NoData 怎么处理、怎么去重、通知什么等级。
DLQ=0也可能是入口没有流量。告警判断要结合流量和数据是否持续上报,避免把“没有数据”当成“没有故障”。
7.6 排障的起手顺序
先固定机器、环境、版本和时间范围,再看日志与 Trace。
我踩过的坑
- 2026-08-27 我问过:“服务器性能方面的问题应该怎么复现?”下面的方法是我准备练的,还没有完整做过一次压测。
正确理解
- 先确定机器、环境、服务、版本和时间范围,再按请求编号查日志和 Trace。没搜到异常时,还要核对容器、日志出口,以及请求到底有没有进来。
- 故障一出就重启,可能丢掉排查线索。先看进程、健康检查、日志和依赖;改配置或数据库前,核对目标、影响范围和恢复办法。
- 复现性能问题:先把“慢”变成能比较的指标,比如 P95/P99、吞吐量或资源占用;再固定代码版本、数据规模、并发量、缓存冷热和请求,留下改之前的基线。按 Trace、慢查询或 profiler 找到瓶颈后,一次只改一个主要因素,用同样的负载复测,并检查功能有没有退化。
- 只在生产出现的问题,可以保留“生产证据充分、本地尚未复现”的状态。Agent 接了任务不代表已经复现。
- 截取 UTF-8 文件开头的几个字节时,可能刚好切断中文字符、解出
U+FFFD,这不能证明源文件坏了,案例见附录 A.7.1。 - CPU 接近 0、TCP 连接是 ESTABLISHED,只能说明进程可能在等 I/O,案例见附录 A.7.2。
- 自动重试还报错时,先确认错误有没有被重试规则匹配上、每次尝试是否真的发生,案例见附录 A.7.3。
来源
《需要学习的》,2026-08-27“Hermes 如何复现普通问题和服务器性能问题”。
排查也要能回退(待学习)
浏览器不出窗口时先查进程的启动参数、父进程和临时配置目录。一次退出残留的无窗口测试实例后,正常窗口恢复,具体争用原因仍未确认。Windows 干净启动案例中,恢复停用的服务并重启后,Wi-Fi 等功能恢复,最初的设置页面异常仍未找到原因。做隔离实验前记下改动的服务或启动项,逐项恢复后用受影响功能复测。给人远程排障时,用标注图指出具体开关,便于按原值恢复。
7.7 HTTP 成功与业务成功
200 只说明接口有响应,还要看解析、权限与写入。
正确理解
- 返回 200 之后,还要检查结果解析对不对、权限规则执行了没有、数据是不是真的写进去了。
- Trace 要记录做出业务决定和真正写入的节点,不能只看外围的 SDK 调用。模型评测和 LLM 专用追踪见《AI Agent 学习》。
- 一次网络或读取失败,不应该把之前成功加载的数据清空。可以用 last-good 缓存回退展示,但要标明 stale 和最后更新时间,不能把旧内容当实时值。首次没有缓存、部分字段坏掉、恢复联网这几种状态切换要单独测。
7.8 降级与 Trace 状态
技术调用失败、业务成功、用户拿到降级结果,是三种不同状态。
正确理解
- 业务解析失败时,代码捕获异常、返回空对象,主流程照常结束。SDK 的自动追踪看到“函数正常返回”,就把这次标成成功。
- 降级的返回值要能区分“合法的空结果”和“异常产生的 fallback”,并记录失败在哪一层、异常类别、影响哪个业务对象、能不能重试,在授权的日志和 Trace 里标成业务错误。
- 只有同时满足这几条才考虑降级:业务允许替代值,上游能识别这是替代结果,不会造成错误缓存或丢数据,有能发现问题的诊断指标。配置、权限、Schema 违约、持续的依赖故障,不能静默吞掉。
- 验证时注入一个最小故障,同时检查返回值、日志和 Trace、上游重试和缓存状态。Langfuse 的具体 API 按当前 SDK 文档核对,不要凭印象写方法名。
来源
10-wiki/personal/wiki/queries/哪些异常应该降级后标记错误而哪些必须继续抛出.md。这是旧排障设计与待验证方法,非特定业务已自动修复的证明。
7.9 读模型与真实任务
读模型只是展示,不能反过来删除真实任务。
正确理解
- 旧 Bridge 排障:本机原始 State 里还有任务和 Run,Snapshot 的活动卡片数却变成 0。一个可能的原因是评分器失败事件被误用来筛选任务,本该显示“待核实、暂时不能派发”的任务被当成了没有任务。
- 读模型展示不是业务主数据,用派生状态覆盖真实任务集合容易制造“任务凭空消失”。设计时要分开三个事实:任务是否存在、任务是否可派发、最新评分/运行是否成功;评分失败仅应改变后两者的状态和错误提示,不应自动删除任务。
- 旧 Run 被 blocked 后,新一次真实结果能不能覆盖它,要用 event/order 和关联 ID 验证。工作台应显示能核对的 Task ID、当前阻塞原因和最近一次真实 Run,而不是假装“没有工作”。
来源
40-AI任务交接/2026/08/31-基础设施层-Bridge当前状态运行问题与worktree清理.md。2026-08 的 read model 故障分析并非今天仍在发生的证明;后续修复和 WebDAV 回读当时待验收。
7.10 审计日志异步化
asyncSend成功只完成生产侧发送,落库和业务完成是另外两步。
正确理解
- 旧网关曾考虑把同步写库改为“网关 Producer → MQ → Consumer → 数据库”以减少入口阻塞。但
asyncSend返回或回调成功,只说明按 MQ 协议完成了生产侧发送阶段;Broker 可靠持久化、Consumer 落库和用户看到业务完成是不同阶段,队列积压、Broker 错误与消费端异常仍可能造成审计缺口。 - 审计没有“必须全部异步”的统一答案:运营日志可按业务要求尽力而为,高成本详情可靠异步落盘;涉及安全决策、交易责任、合规与风控的记录则要满足审计完整性,需考虑稳定事件 ID、与业务事务的关系(如 Outbox)、消费端幂等写入、失败重试、死信告警及人工核对/对账。
- Consumer 捕获异常后正常返回,可能让 Broker 误认已消费;抛出异常能否重试,仍取决于确认协议、重试上限、DLQ 和实例失败行为,不能保证“100% 不丢”,无限重试也可能让坏消息堵住消费。具体可靠性要用故障重放验证。
- 密钥和隐私数据在第一次持久化、上传外部平台之前就要脱敏,见第 7.2 节。
- 旧稿里的 RocketMQ 和 MongoDB 只是当时的候选,没有在所有项目落地;也不能因为 MongoDB 没有 Schema 就认定它最快、最安全。
来源
历史《微服务网关日志与RPC边界复盘》,旧库 90-归档/20-个人/20-草稿箱/待写选题/微服务网关日志与RPC边界复盘.md · 公开参考:Python logging Filter。
本章原始笔记
- 案例:主链 + 快链 + 应有账本的对账设计、按模块拆的成功 / 失败 / 慢请求计数器、SigNoz 与 Tempo 的取舍,见实时数据链路。
7.11 先查命令解析与启动依赖,再查登录和模型(待学习)
二进制版本正常而日常命令提前退出,先查 alias、同名函数与 PATH;包装器只取凭据却没调用程序,就不会启动。它还应转发参数和退出码,并把凭据限制在目标进程。
交接报未登录也可能是本机路由应用没启动:分别核对可执行文件、代理监听、模型认证与 MCP 授权。自启登记不是重启恢复证据。原生协议不支持、第三方能适配、本机已接通分开;先查现有配置管理器能力,不重复安装代理。
来源与当时边界
详细条件与线索:《客户端启动路由与压缩排障》。
7.12 上游连通要从真实部署机器验证(待学习)
本机 API 和工具请求成功,生产仍可能卡 DNS 或 TLS。从实际发请求的机器先用无凭据探针测 DNS、TCP/TLS,再测鉴权、模型与完整业务;站点 health 不替代模型验收。恢复旧配置后旧通道也可能 401,回退结果另验。替代运行环境还要核对任务时长与资源限制,未完成的长期出口迁移继续标待确认。
来源与当时边界
7.13 吞吐与延迟都要写清分母和失败范围(待学习)
原创、引用、回复和转发可以是不同记录;按记录 ID 去重不等于事件去重。报日期口径、唯一记录、来源形式、完成和跳过数,区分本轮新增与历史已做;人工审阅积压时可以暂停扩量。
5 次请求仅 3 次成功,成功样本 P50 为 1.803 秒,另 2 次超时,就不能只报这个中位数。诊断时放宽等待与正式严格配置分开统计,注明失败阶段、分位数是否排除失败,再谈性能与可用率。
来源与当时边界
7.14 停止事件能解释故障,不能自动证明操作人(待学习)
网关 503 先核对后端注册与健康。容器停止和注销记录可说明请求为什么到不了业务,却不必包含操作人;同时间登录不证明是谁操作。共享账号、自动部署与持久会话都影响归因,已知事件、人员线索和未知原因分别记,可靠追责需要预先建设审计。