第 6 章 Agent 服务化、多入口与多 Agent 协作
6.1 Agent Core 与多入口 Adapter
网页、微信、HTTP、CLI 各由 Adapter 把协议和消息格式转换成统一请求,共享同一套 Agent Core。Adapter 负责入口差异,Core 负责业务执行。
我踩过的坑
2026-06-20 的几处混淆:
| 我的错误理解 | 正确理解 |
|---|---|
| 特定入口多一个业务规则,就一定需要 Hook。 | 先看它能否表达为明确的业务参数或独立业务规则;Hook 只是实现方式。 |
| 新增 HTTP 入口,只要改请求模型。 | 核心契约足够时应新增 HTTP Adapter,原有 CLI 入口仍保留。 |
| Core 有 Bug,要分别在 HTTP 和 CLI 各修一遍。 | 共享业务逻辑只修一次,各入口仍分别验证;独立部署的实例也要更新版本。 |
| Core 只管生命周期,不处理业务流程。 | Core 执行业务,Lifespan 等生命周期机制负责准备和释放资源。 |
| 语音入口用 WebSocket 就够,Adapter 没多大用。 | 文字 Core 接语音时还需要音频/文字转换(如 ASR、TTS);原生音频模型则可采用其他结构。 |
正确理解
- 接口边界示例:Core 不直接返回 FastAPI
Response,否则 CLI 也得理解 HTTP 框架。Core 返回内部结果或事件,由各个 Adapter 转换成 HTTP 响应、终端文字或平台消息。 - 一个 Core 服务多个入口,不要求每个入口拆一个进程。 CLI、网页、微信可以通过 Adapter 在同一进程里调用 Core,也可以部署独立的 HTTP/RPC 服务,取决于规模、连接可靠性和故障隔离需求。旧稿里“四个进程 + Watchdog 秒级检测 + kill -9 自愈”是架构设想,不是本项目验收过的事实。杀掉再启动不等于恢复了任务状态,还要考虑在途消息、持久检查点和退出清理。
- IM 连续发消息,可以按会话或发送人做短窗口聚合。 用户把一句话拆成多条发,如果每条都立刻触发 Agent,会出现上下文不全和多余调用。可以用防抖,在一个有最大等待时限的窗口内合并同一个逻辑输入。窗口太短仍会截断用户意图,太长会增加响应延迟;图片、文字和提及对象也要保留顺序和归属。这是应用层的防抖或消息批处理,不是以太网 CSMA/CD 协议;旧稿固定的“静默 3 秒”只是候选参数。
- 多入口的会话隔离和界面动作互斥不在同一层。 旧“小萤”在 QQ/抖音实践中给不同渠道建了不同的会话键,并在共享浏览器页面的物理发消息操作外面加了
asyncio.Lock防止焦点冲突。但独立的 session key 不代表进程或内存物理隔离,浏览器操作互斥也只保护那一段关键区间,不能保证消息一定投递成功或断电不丢。源笔记里“绝对不会冲突、100% 交付”是旧设计目标,不是本轮完成的并发压力验收。 - 私聊会话键必须包含足够的身份维度。 多用户、多账号共用一个 Agent 时,不能让所有 DM 都落到一条
main会话,否则可能把一个人的历史注入另一个人的回答。至少在可信的 Gateway 层按账号、真实发送者、渠道和会话类型建立隔离,检索长期记忆时再验证所属用户;群聊成员的可见范围也和私聊不同。不同的 Session Key 只是逻辑寻址上的隔离,实际的存储、缓存和权限边界仍要落实。 - 云端模型可用,不代表整条机器人链路在本机离线后仍可用。案例见附录 A.6.1;飞书群白名单为空、消息在策略层被拒绝的案例见 6.7。
6.2 请求结构、用户权限与依赖注入
进入 Core 前准备好已校验的请求、用户身份和所需资源;访问具体会话或执行业务动作时仍要检查权限,不能只验证字段格式。
正确理解
- FastAPI 请求链和我的三个概念混淆,集中在《系统架构与工程化学习》第 2.2、2.4 节。
- 异常契约见该书 2.3 节:对外返回可处理的错误,对内保留排障证据。
6.3 HTTP、SSE、WebSocket 与长任务
传输方式和任务执行方式分开设计:长任务提交后返回
task_id,后台执行,客户端查询或订阅进度。
正确理解
- 客户端需要持续推送还是实时双向交互,决定用哪种传输接口;同一个服务可以同时提供 HTTP、SSE、WebSocket 多种入口。
- 长任务流程:提交任务 → 返回
task_id→ 后台执行 → 查询或订阅进度。Adapter 把内部事件转成网页进度或平台回复;任务本身要有持久状态和恢复策略,不能只依赖一条连接。 - 协议差异、断线补收与取消机制统一见《系统架构与工程化学习》第 2.1 节。
- Durable 是“持久”这个属性,不是某个工具的名字。 把定时任务定义存进数据库或文件,重启后可以重新读取;但进程停止期间,进程内的定时器不会继续运行。要求服务宕机时也照常执行的定时任务,要把调度和执行放进能独立运行、支持恢复和去重的系统。
- 长任务恢复要避免无限转圈。 设过期和失败终态、总时限和重试上限,给用户能看懂的重新提交或查询入口。案例见附录 A.6.2。
6.4 子代理与并行
主 Agent 负责判断和整合,边界清楚的小任务交给子代理;并行的前提是任务独立。
图解:编排、执行、汇总分别负责什么
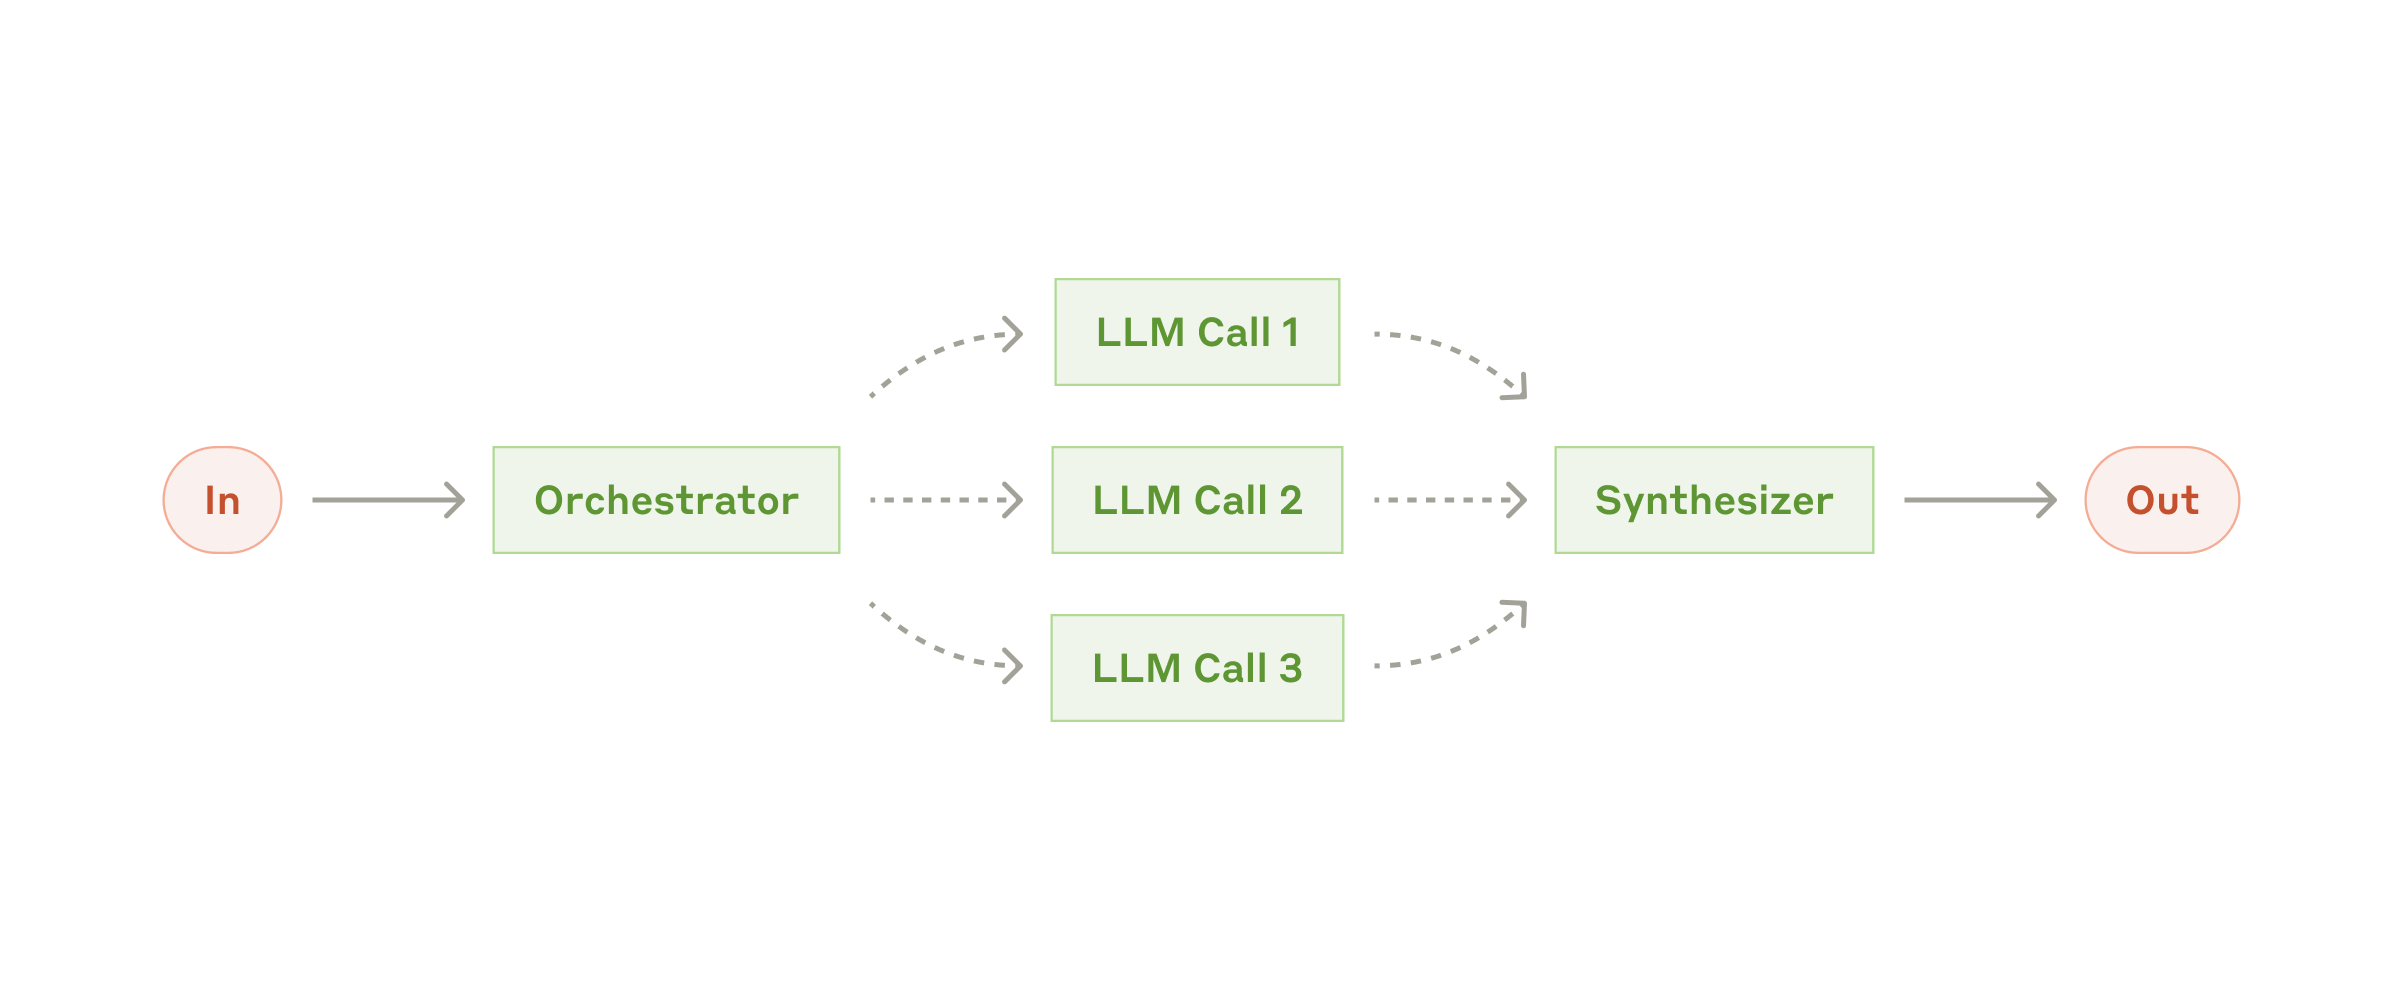
读图: 编排者拆分任务,执行者处理子任务,汇总者整合结果。能否并行仍取决于依赖和共享状态,图不代表多个 Agent 可以同时改同一份数据。
来源:Anthropic《Building effective agents》Orchestrator-workers 原图(2024)。2026-10-28 核对。
我踩过的坑
Claude Code 协作学习中的三处混淆:
| 我的错误理解 | 正确理解 |
|---|---|
request_id 负责“告诉哪个 Agent”。 |
收件人/会话 ID 解决寻址;request_id 解决回复与哪次请求配对。 |
| Git Worktree 和悲观锁差不多,要排队修改。 | Worktree 让多个任务在独立目录、分支并行改动;合并时可能仍有冲突,不能免掉验证。 |
| 多 Agent 领取任务必定由主 Agent 手工分派。 | 系统也可以让闲置 Agent 自主扫描未分配任务、原子领取;是否这样设计取决于任务系统,不是每个 Agent 框架默认具有。 |
正确理解
- 子代理适合查资料、读调用链、跑测试。并行前先看依赖;多个代理同时改文件,还要隔离或约定各自负责的范围。
- 上下文隔离、文件隔离、执行权限是三件事。 多个 Agent 通信要有会话或接收方身份和 request_id,能识别超时、重复回复和失败回传。
- 文件邮箱、轮询领取和团队状态机等细节来自当时读的教学源码,不核对版本就不能当成今天 Claude Code 的固定行为。
- DAG 看板要分别记录依赖和领取状态。 前置任务真正完成并验收后,后续任务才能领取;原子的
claimTask要同时记录 Owner 和租约,避免两个 Worker 同时认领同一个空任务。但领取一次不保证业务恰好执行一次:超时、租约过期或 Worker 崩溃都可能导致重复执行,仍需要幂等和恢复。 - 循环依赖、永久失败的父任务、永远不释放的租约,都可能让流程卡住。要检查不可达的依赖、超时、失败传播和重试或人工处理,而不是无限轮询。独立分片能提高吞吐,但并行结果合并时仍要校验;让多个模型对同一个错误事实投票,也不保证正确率提高。
- 文件邮箱不是天然无竞争、永不丢消息。 多代理可以用消息总线、受控的 JSONL 或共享任务表传递状态;用文件方案要做原子写入、文件锁、消费进度和异常退出后的恢复。审批状态要区分待审、批准、拒绝和过期,遇到未知结果不能用高频轮询代替正确的权限处理。TaskBoard 即使有 Owner、任务租约和日志,也要另外处理重试幂等和过期清理。
- 子代理缺信息时,要能提问、等待并继续原任务。 2026-09-17 的 dispatch 调研提出一种文件通道:Worker 写 question,主代理转给用户,再写回 answer;等待时保留任务上下文,超时就保存进度并明确进入待答状态。文件要写完整,重启时还要查哪些问题仍未回答,不能只恢复任务清单。原项目的 3 分钟是历史示例阈值,不是通用默认值。
- 回答要带身份和版本,防止迟到、重复或写一半;先用只读任务验证现有框架确实支持恢复,再决定 IPC 的实现。只有心跳和进度不够,遇到缺权限或歧义时,子代理要能提交问题 ID、暂停,拿到回答后沿原 worktree 和任务继续。
- 当时个人编排已经有产物落盘、轮询和断连预案,但还没验证 Pi Worker 能否在运行中读取新增文件。后续记录称 PR #79 已补流程并合并,封存时仍把运行验证列为待办,后来转为 Issue #117。所以这里只保留为可验证的方案,不能写成已实现的后台问答能力。
- 看子代理是否在工作:状态卡、事件流、主动轮询是三种机制。 事件没送到但状态文件更新了,说明“有日志”不等于“订阅可靠”。主代理要掌握 task ID、最后进展、心跳和终态,有变化时再汇报,不必先做复杂看板。
- 用户想“一张图看进度”,不一定要做一个新的看板产品。 先保证 Worker 的进度事件和最终结果能可靠回传主代理,区分“运行中、阻塞、已完成、已取消”,再决定用聊天简报、卡片还是网页展示;任务完成了,界面上不能还长期显示忙碌。
来源
旧库 90-归档/20-个人/20-草稿箱/AI规范优化收件箱-20260923-最终封存.md 第 17—22、329—335 行;封存入口 20-个人/10-草稿箱/AI规范优化收件箱.md 第 23 行。原调研对象为 github.com/bassimeledath/dispatch,本轮未复查项目现状。
并行交付越快,越要防止理解债(课程摘记,待学习)。原文把“Agent 循环交付代码的速度越快,工程师对系统实际实现的理解就落后得越远”称作理解债,也提醒人可能逐渐放弃自己的判断。使用多 Agent 时,我可以优先读清关键契约、失败路径与实际变更,并用自己能解释的验收确认结果;代理相互赞同不能替代我的理解。
来源:书-AI Agent 实战营-第10章-多Agent协作。
6.5 错误边界与恢复
先定义错误边界,局部失败才可能被限制住;模块解耦不等于物理资源隔离。
我踩过的坑
- 以为“数据有问题才会造成隔离”。
正确理解
- 即使入口 Adapter 不同,也可能共用事件循环、连接池、队列和 Core,要按实际风险设置超时、并发上限、隔离和恢复策略。
- 例如微信消息解析失败不应拖垮网页;SSE 断线不应自动判定后台任务失败;单个 Tool 超时不能无限占用资源。重试要限次数并保证副作用幂等,隔离是否有效要用失败路径验证。
- 长任务恢复不只是恢复聊天文本。 历史消息可以重新显示,但要继续执行,还要核对已完成和待执行的 Tool Call、任务状态、外部副作用、执行凭据和持久检查点。旧源码学习里的会话链修复只是某种实现案例;能否继续工作必须实际验证,不能凭“会话列表能打开”就认定已恢复。
- 旧多入口 Agent 方案:顺序处理不等于消息可靠。 同一会话用 FIFO 队列顺序处理消息,可以减少并发改 Context 的冲突;GUI 任务还要协调当前桌面焦点。但内存里的排队和补偿任务会随进程崩溃丢失,发出后没收到确认又重投,可能造成重复副作用。高价值消息要有持久化队列、状态回执、有限重试和幂等检查。旧稿“每 5 秒重投保证零丢失”是待验证的设计,不能当承诺。
- 子代理注册表只描述了要恢复哪些任务,不会让它自动安全地续跑。 服务重启后,还要核对检查点、已发生的外部副作用、认领租约和去重标识,再决定恢复、补偿还是停下待审。不能因为启动时找到未完成记录,就重新支付或重复发通知。旧草稿“写盘即一键恢复并跑完”是未验证的设计。
来源
协议与服务化细节:Agent 服务化。
执行器和调度器可以在不同地方(待验证)
给 Bot 配云端电脑前,先找出谁接收事件、谁保存待执行任务、哪个常驻进程负责派发。执行器在线时,如果负责定时的应用已经退出,任务仍可能没有人派发。测试要分开记录准点触发、停机窗口内的漏跑和恢复后补跑,以及等待人工审批时的状态。已有源码记录,待实际重启验证。
6.6 TaskCard → Bridge → Executor
有任务不等于允许派发。工作台提交真实 TaskContract ID,Bridge 校验授权与来源,Executor 执行并产出真实 RunHandoff,看板只接收可核对的结果。
我踩过的坑
- 旧个人工作台先做出了任务池和“运行此任务”按钮,却没有真实可验证的 Task ID。把界面标题拼成
issue:来源:标题看似能派发,实际可能执行错误的目标。
正确理解
- Bridge 负责校验授权、allowlist、幂等和来源。用户点了一条旧 Issue,它只有历史标题、没有真实的
task_*,就应该可查看、不可执行。 - Bridge 返回
no_dispatch,也可能只是“本次没有符合派发条件的任务”,不能让所有任务从界面消失,更不能伪造成功的 Run/Commit/PR。 - 可见的任务和可自动派发的任务不是一回事。Bridge 执行前必须重新核对真实 taskId、归属、状态和可信证据;证据不够时,先让 AI 只读核查补齐再派发,既不能绕开权限,也不要把所有任务永久卡在人审。
- 派发、评分、执行和终态要各自保留事实,评分异常单独记录,按 runId 更新后续状态。案例见附录 A.6.3。
- 首次实现批量执行时保持串行:同一仓库的任务可能改共同的文件或复用上下文。独立工作区、冲突检测、证据归属和强制停止机制都可靠之后,才考虑并发。
- UI 按钮能点和真实 Hermes 任务闭环是两项不同的验收。 真正达标,要看到用户动作 → 请求 → Bridge/outbox → Executor → RunHandoff → 当前页面状态一一对应。
来源
40-AI任务交接/2026/08/29-个人工作台与基础设施层-AI任务调度-数据流展示与Bridge联动.md。当时 PR #8/#19 已有局部工程结果,但完整非生产调度回流仍未证实,不能写成现已端到端验收。
6.7 飞书 Bot 收不到群消息
能主动发消息,不代表群消息已经进入 Agent。发送、接收、事件订阅和频道策略是不同的环节。
我踩过的坑
- 旧小萤接入飞书时,确认机器人能往群里发测试消息,却收不到群聊内容。早期怀疑缺
im:message权限,以为“只要申请总读取权限就好”;后来发现还涉及群消息 scope、是否真正 @ 了机器人、群策略 allowlist。其中一次排查发现 Gateway 群白名单为空,已收到的消息被策略层静默拒绝,常规日志里看不到。
正确理解
- 只看发送成功或一项 API 权限,判断不了双向链路是否打通,要同时看实际的群模式和当前应用权限。
- “日志里没有消息”不能单独推出飞书没送达,也可能是日志级别、adapter 去重或频道过滤。
- 权限名、事件格式和发布要求依赖平台版本,2026-08 的记录不能当成现在的自动接入指南。
动手前检查
- 按顺序查:发送目标群是否正确 → 事件订阅种类和群权限 → 实际消息是否 @ 到 Bot → 平台是否已向适配器投递 → adapter 是否因白名单或幂等过滤而拒绝 → gateway 是否进入处理循环 → 最终回复回执。
- 记录消息 ID、接收时间和过滤原因即可,不要把群里的正文或凭据复制进知识库。
来源
旧任务交接 40-AI任务交接/2026/08/14-小萤agent-飞书群消息权限.md。
6.8 恢复先核对同次执行,再补保存或取证(待学习)
网页自动化超时先分清未发送、已发送未收到、已有回答提取失败;有原对话就先读取,不默认重问。预期字段校验作为普通跳过结果,登录验证、额度限制或未知提交保留待确认。
禁用按钮防不了回包丢失:外调前持久登记执行标识,重试回读原记录;事务别在等外部服务时占连接。业务完成、结果保存和取证完整分别落状态。数据库提交后回包断开要幂等补读;执行前在锁内核对最新版本。晚到证据可补同一次执行,完整结果不被空值降级,人工决定不被自动覆盖。需持久检查点并故障注入,finally 不保证重启恢复。
来源与当时边界
原始记录 2026-10-29 · 原始记录 2026-10-29 · 原始记录 2026-10-29 · 原始记录 2026-10-30 · 原始记录 2026-10-31
6.9 远程调用渠道与条件写协议都要实测(待学习)
交付 CLI 不能证明云端 Agent 已有调用渠道,私人 MCP 还要完成合适的 OAuth。gzip 路径可能把强 ETag 变为弱 ETag;不能删 W/ 冒充可供 If-Match 的版本。调整响应策略后重测:本地协议、线上生效和真实客户端连通分别留证,实际连接仍待验收。
来源与当时边界
6.10 Bot 消费端唯一,资料范围按团队授权(待学习)
复用个人 Bot 前先找现有 getUpdates 或 webhook 消费者、部署位置和用途,不盲启第二消费者;接收方式互斥不代表现状已经查清。由受控入口路由 Agent。
知识库 personal/company 是资料分区,不是三人成员 ACL。团队只查明确授权给全群的集合,搜索和原文读取都限制范围,只开必要只读工具;不直接暴露个人 scope,不为接入新增 scope。实际消费者、仓库和资料授权仍待确认。
来源与当时边界
6.11 消息提交后再确认,恢复前先重放遗忘标记(待学习)
拿到消息、进入 SDK 内存队列、消息和任务事务提交,是三个时点。查 offset 在哪步推进,再在提交前后强制结束进程,验证重收与任务恢复。合成中断通过仍不等于真实群验收。
从记忆遗忘不等于清除所有备份;旧库可能带回原文。独立保存最新遗忘标记,恢复旧备份后先重放,再开放检索;消息与派生摘要都测是否复活,历史备份处置仍单独验收。